
Business intelligence
Toată piața de business a României, într-un singur loc de întrebat
Firme, licitații publice, legislație și dosare — agregate, legate automat între ele și interogabile cu asistenți care răspund cu trimitere la sursă.
- Client
- LaTermen
- Sector
- Business intelligence
- Publicat
- Site
- latermen.ro
Scara datelor
- documente legale
-
130.000+
documente legale
- dosare de instanță
-
200.000+
dosare de instanță
- asistenți specializați
-
5
asistenți specializați
Cifre publicate de platformă pe latermen.ro, citite pe 9 octombrie 2026 (pagina de start, /legislatie, /dosare). Formele rotunjite sunt intenționate: o numărătoare exactă s-ar învechi.
Ce rezolvă
-
Verificarea unei firme îți mănâncă o dimineață întreagă?
Un profil agregat — registrul firmelor, fiscul, bilanțul, dosarele — într-un singur ecran.
Problema -
Datele sunt împrăștiate pe zeci de portaluri care nu vorbesc între ele?
Un singur cont și un singur câmp de întrebare. Restul se leagă automat.
Soluția -
Nu vezi legătura dintre o firmă, licitațiile și dosarele ei?
Firma este nodul; ce o atinge se leagă de ea fără să întrețină nimeni legătura de mână.
Cross-linking automat -
Munca de documentare pe care nimeni n-o apără mănâncă orele celor mai buni oameni?
Asistenți care urmăresc piața și raportează ce se potrivește profilului.
Cinci asistenți specializați -
Un răspuns dat de AI nu se poate verifica?
Fiecare pasaj vine cu autoritatea emitentă, adresa și articolul din care a fost citit.
Citarea ca proveniență
Contextul
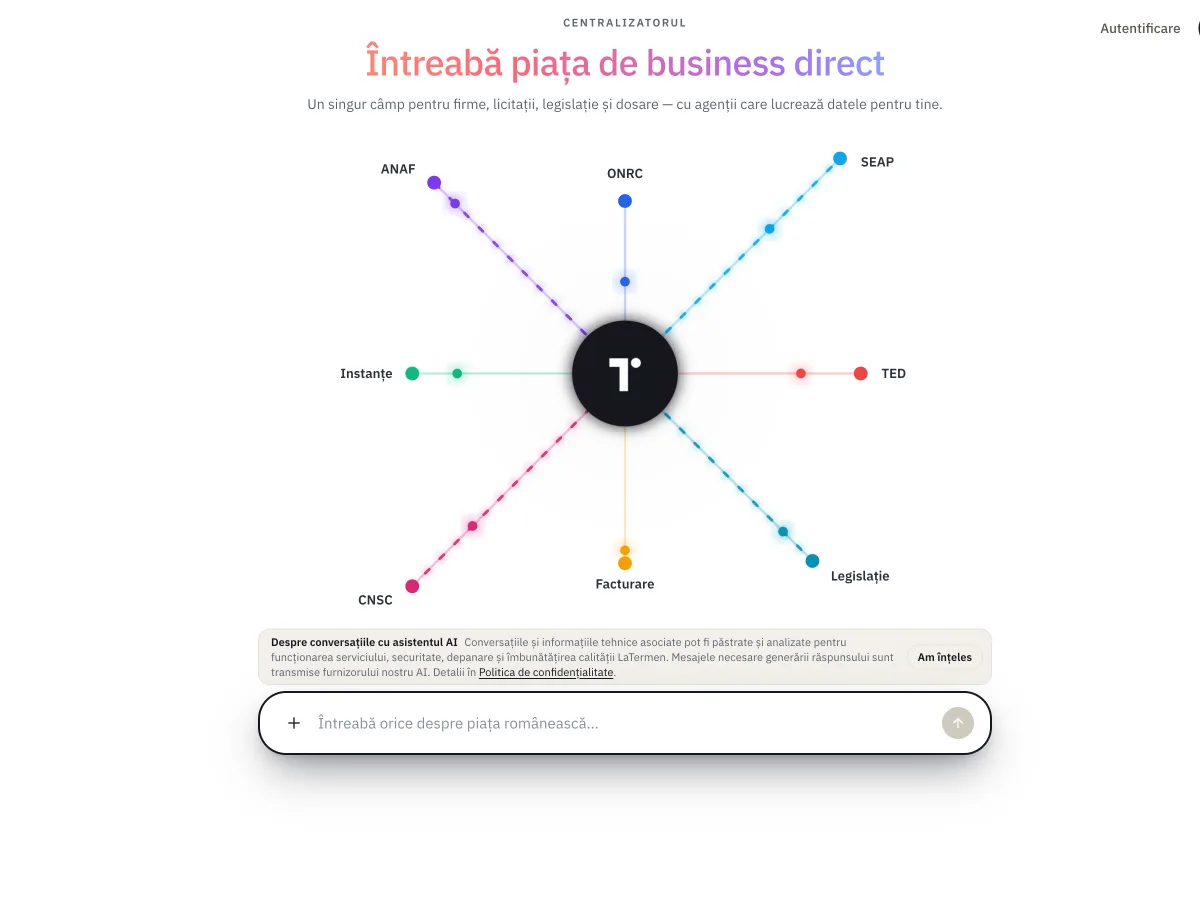
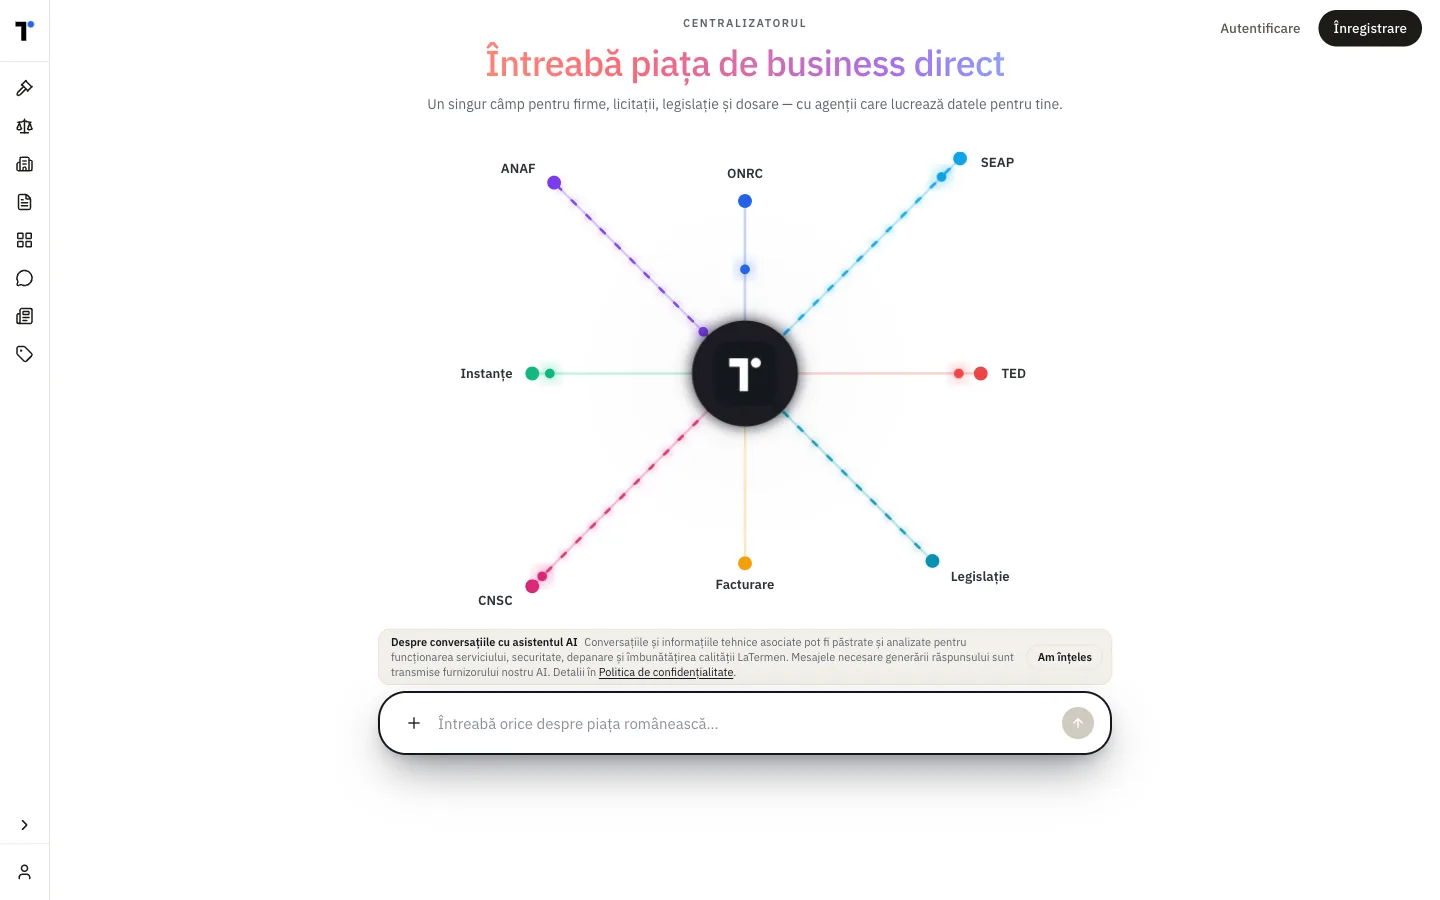
Datele publice ale României există și sunt împrăștiate. Firmele într-un registru, licitațiile la SEAP, fiscalul la ANAF, dosarele pe portalul instanțelor, legislația în Monitorul Oficial, deciziile la CNSC. Fiecare pe alt portal, cu altă căutare, cu alt format, și niciunul nu știe că există celelalte. Cine vrea să verifice un partener sau să găsească o oportunitate sare între zece surse, copiază de mână și tot nu vede întregul.
Problema
Munca grea nu este găsirea unei informații. Este adunarea lor și legarea între ele. Verificarea unui partener înainte de contract este o dimineață pierdută printre portaluri, cu riscul real să scape exact dosarul care conta. Făcută de zeci de ori pe lună, devine corvoada care mănâncă timpul celor mai buni oameni pe cea mai puțin creativă muncă.
Soluția
Platforma preia corvoada asta. Un singur cont, un singur câmp de întrebare. În spate: registrele oficiale aduse la un format comun, legate automat între ele, și un strat de asistenți care lucrează datele. Se introduce codul fiscal și rezultatul este firma, licitațiile ei, dosarele ei, bilanțul ei și semnalele de risc. Nu zece taburi. Un profil.
Arhitectura
Trei lucruri fac diferența, dincolo de mai multe date ținute la un loc: felul în care intră datele, felul în care se leagă între ele și ce se întâmplă când cineva pune o întrebare peste ele.
Ingestia multi-sursă normalizată
Fiecare sursă oficială are alt format, altă cadență și alte reguli. Toate trec prin același contract de adaptor — decide dacă poate trata sursa, ia o pagină, extrage elementele, le normalizează, spune dacă mai urmează una — deci un portal citit ca HTML și un flux deja structurat produc aceeași înregistrare, iar sursa următoare este o clasă, nu un proiect. Fiecare sursă are propria cadență așteptată și propriul verdict de sănătate: o ingestie pe care n-o vede nimeni este un set de date care se oprește în tăcere.
Cross-linking automat
Firma este nodul central. Registrul firmelor, licitațiile, atribuirile, dosarele, legislația și facturarea se leagă de ea singure. Fișa unei firme nu este o pagină despre firmă; este punctul în care se adună tot ce spun celelalte registre despre aceeași entitate. Din cauza acelei legături platforma răspunde la o întrebare la care niciun portal luat separat nu poate — și se calculează, nu se întreține de mână.
Cinci asistenți specializați
Licitații, legislație, risc de firmă, prospectare și documente. Fiecare lucrează pe corpusul lui și pe filtrele lui, nu pe o casetă de chat generală care încearcă totul. Limbajul obișnuit este tratat ca metodă de introducere, nu ca autoritate: fraza ajunge la un model care extrage sloturi, iar sloturile trec printr-un mapper determinist în filtre validate. Modelul nu execută nimic, iar interfața spune înainte ce filtre urmează să ruleze.
-
Licitații
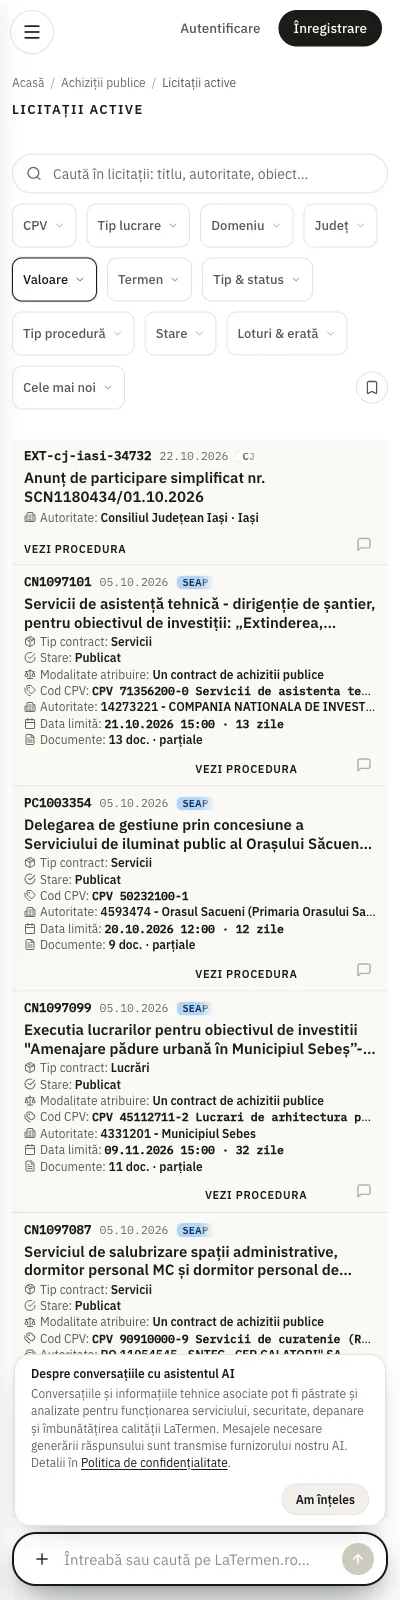
Urmărește sursele publice, filtrează pe profilul firmei și semnalează ce se potrivește, cu autoritatea și istoricul de atribuiri lângă anunț.
-
Legislație
Răspunde peste corpusul de acte normative și jurisprudență indexate, cu trimitere la documentul din care vine fiecare afirmație.
-
Risc de firmă
Evaluează parteneri și concurenți pe semnale publice — starea din registru, bilanț, dosare, insolvență — și explică din ce se compune scorul.
-
Prospectare
Construiește liste de firme țintă pe cod de activitate, județ, mărime și performanță financiară, exportabile mai departe.
-
Documente
Completează formulare din datele deja existente în profilul firmei și în anunțul de licitație, cu export în mai multe formate.
Citarea ca proveniență
Aici începe de obicei o platformă ca asta să mintă, iar designul este construit ca să n-o lase. Regăsirea întoarce o structură, nu text: pasajul, autoritatea emitentă, adresa și, unde există, articolul din care vine. Citarea este un câmp pe rezultat, nu o instrucțiune în prompt. Deci răspunsul se poate verifica față de lucrul din care a fost scos — singura variantă de răspuns dat de AI care valorează ceva într-un context profesional.
Rezultatul
Verificarea unei firme care însemna ore de sărit între portaluri devine un singur profil agregat, în minute. Munca de documentare făcută manual este preluată de asistenți care urmăresc piața continuu. Iar decizia — cu cine se lucrează, la ce licitație se participă — se ia pe date legate și verificabile, nu pe zece taburi copiate de mână.
În detaliu
Partea grea n-a fost niciodată modelul. Este că sursele nu sunt de acord asupra nimicului, în afară de fapte. Un portal identifică firma după codul fiscal, altul după numărul de înregistrare, al treilea după o denumire scrisă de mână, cu forma juridică pusă de fiecare dată în alt loc. O licitație e o pagină pe un site, o înregistrare structurată pe altul și un PDF atașat pe al treilea. Înainte să se poată întreba ceva, toate astea trebuie să devină o singură formă.
De aceea fiecare sursă implementează același contract, iar nimic din aval nu știe ce fel de sursă a fost. Decide dacă o poate trata, ia o pagină, extrage elementele din ea, le normalizează într-un set fix de câmpuri — titlu, adresa sursei, data publicării, termenul, valoarea, moneda, codul de clasificare — și spune dacă mai urmează o pagină. Un portal care trebuie citit ca HTML și un flux care vine deja structurat produc înregistrări identice, și exact asta face din sursa următoare o clasă, nu un proiect.
O ingestie care rulează o dată este o demonstrație. Fiecare sursă își are cadența ei așteptată și este evaluată față de ea, cu un verdict de sănătate pe sursă, nu un număr pentru tot sistemul. Distincția contează mai mult decât pare: o platformă care adună zeci de registre va avea întotdeauna unul care și-a schimbat marcajul azi-noapte, iar întrebarea utilă nu este niciodată „sunt datele proaspete“, ci „care dintre ele nu mai este, și de când“.
Legăturile dintre surse sunt produsul. Fișa unei firme nu este o pagină despre firmă; este punctul în care se adună tot ce spun celelalte registre despre aceeași entitate — licitațiile la care a participat, contractele pe care le-a câștigat, dosarele în care apare, depunerile pe care le-a făcut. Din cauza acelei legături platforma răspunde la o întrebare la care niciun portal luat separat nu poate: nu „ce ține registrul ăsta despre firma asta“, ci „ce e adevărat despre firma asta“ — și se calculează, nu se întreține de mână.
Căutarea trece prin opt corpusuri într-o singură rulare — firme, licitații, atribuiri, planuri de achiziție, anunțuri europene, cumpărări directe, documente legale și dosare — printr-o interogare multi-index, nu prin opt căutări una după alta. Corpusurile rămân separate pentru că au într-adevăr câmpuri diferite, iar rezultatele se contopesc la final, cu tipul purtat mai departe, ca cititorul să vadă dintr-o privire ce fel de lucru este fiecare răspuns.
Asistenții sunt locul unde o platformă ca asta începe de obicei să mintă, iar designul este construit ca să n-o lase. Regăsirea este un contract cu două drivere în spate — unul care compară documente întregi, altul care compară pasaje — și ce întoarce nu este text, ci o structură: pasajul, autoritatea emitentă, adresa și, unde există, calea de titluri și numărul articolului din care vine. Citarea este un câmp pe rezultat. Deci răspunsul poate fi verificat față de lucrul din care a fost scos, singura variantă de răspuns dat de AI care valorează ceva într-un context profesional.
Aceeași reținere se vede și la interpretarea întrebării. O frază scrisă în limbaj obișnuit ajunge la un model, care extrage sloturi — un sector, un județ, o stare fiscală — și se oprește acolo. Modelul nu execută nimic: sloturile trec printr-un mapper determinist în filtre validate, iar filtrele rulează exact calea pe care o rulează și constructorul manual. Apoi interfața spune, într-o singură propoziție construită fără un al doilea apel la model, ce filtre urmează să se execute — deci o interpretare greșită se vede și se poate corecta înainte să întoarcă ceva. Limbajul este tratat ca metodă de introducere, nu ca autoritate.
Tehnologii
- Laravel 12
- PHP 8.2
- Filament 3
- Meilisearch
- MySQL 8.4
- Redis 7
- Horizon
Competență
- Software la comandă
- AI aplicat
- Platforme de date
Ecrane
Contact